1. 理论边界梳理:在 \(N\) 个节点、数据量为 \(S\) 的场景下,Ring-AllReduce 总传输量为 \(2 \times \frac{N-1}{N} S\),网络开销独立于节点数,但步骤数达到 \(2(N-1)\),高延迟网络下延迟项成为严重瓶颈。
2. Tree-AllReduce 对比:步数为 \(2 \log_2 N\),但在节点数量较大且带宽不对称时,根节点易发生带宽拥塞。
3. 跨机房混合拓扑决策:机房内部(NVLink)使用 Ring,跨机房(WAN)采用双向分层聚合树(Hierarchical Tree),避免跨域长链路串行等待。
一、跨机房分布式 AllReduce 架构选型与边界证明
在跨数据中心(WAN)环境下,节点间往返时延(RTT)通常在 10ms~50ms 之间,远大于机房内 RoCE/Infiniband 的微秒级延迟。此时若盲目采用标准单环 Ring 架构,单次同步等待开销将呈线性剧增:
网页版三大交互亮点
专为科研推演、复杂全栈审查与超长技术标准解析打造。
长思维链全透明溯源
完整展现模型的自省反思草稿纸,随时回溯逻辑分支与证伪切片,让复杂推导步步有据。
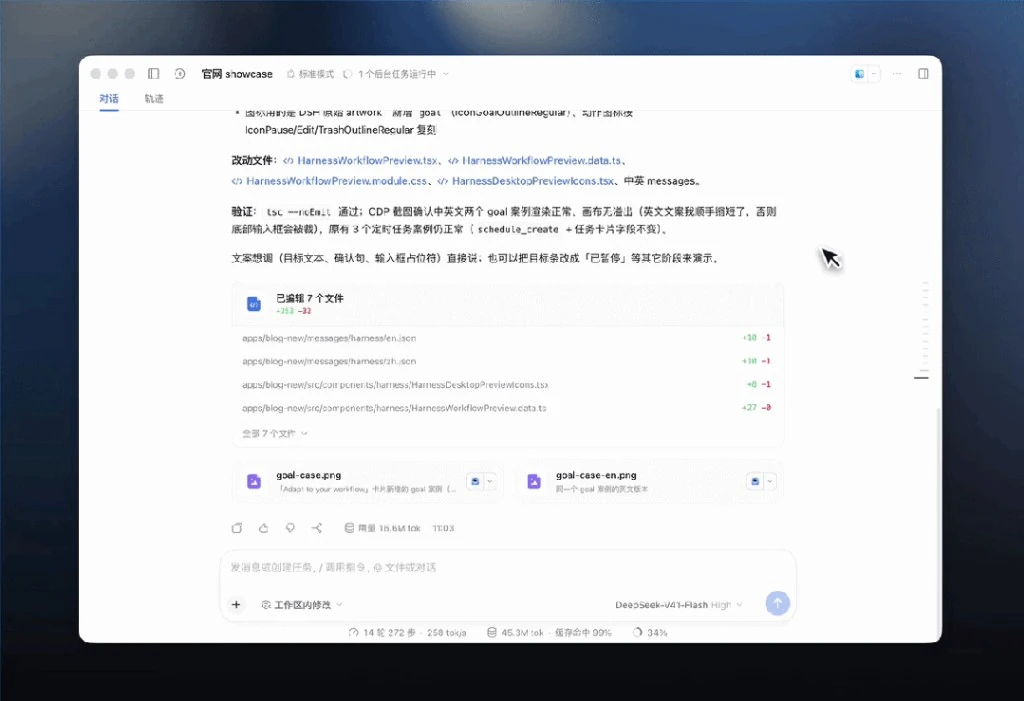
全栈工程深度审查与重构
支持跨文件多模块协同诊断,精准捕获并发竞态与显存泄漏,输出可直接合并的代码 Patch。
128K 文献精准语义召回
整本技术规约、百页学术文献直接拖拽解析,依托 MLA 架构在百万 Token 级长文中实现零幻觉问答。